最近看公众号文章,openclaw已经没了热度,即使刷到,也是“openclaw死了”这样的标题,但是真的是这样吗?我先放一张图,我最近截的github星星排行榜:
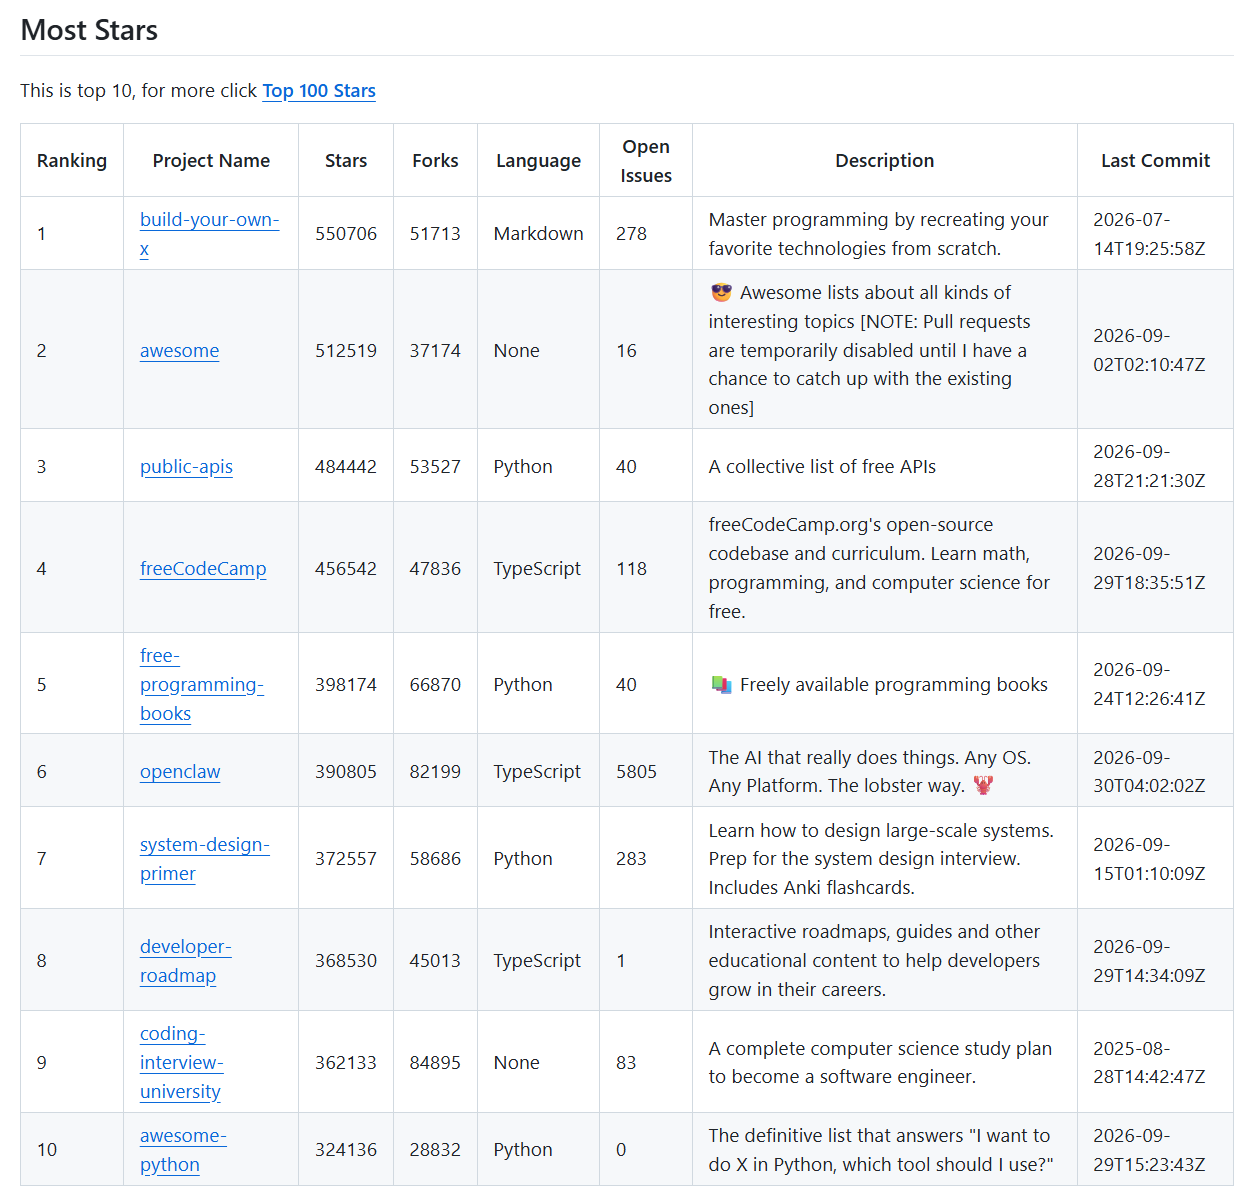
OpenClaw排名第六,而且排在它前面的,都不是真正的开源软件项目,排在它后面的也不是(前10),都是些编程学习资源,看来大家都喜欢搜集免费资源啊。我不是想说openclaw有多好,它的使用门槛确实仍然很高,只限于专业技术人员(可能不少开发人员也跑不顺利吧),但是它仍然是技术人员用的最多的开源项目之一,而且它是完全开源的,有足够的灵活度,应该也是国内一众harness的模仿(如果不是抄袭)的对象。如果没有openclaw一炮打响,想腾讯workbuddy这样的产品,估计会挽很久才出来。这个就像linux,有个最初的内核,就会有更多的系统厂家来基于它,发布自己维护的版本,也会有更多软件厂商来基于这个操作系统来构建和发布自己的软件。现在有越来越多的CLI,MCP,SKILL等等,已经逐渐成长为一个生态。
那为什么这么多人说“OpenClaw已死”,我想大概是非傻即坏,傻的就是缺少批判性思维,去验证其他人的说法是不是事实,去思考别人的思维逻辑是否正确,或者自己完全不懂,不会用,甚至没用过,久盲从别人的说法。坏的那些大概就是用一个标题来吸引眼球,获得流量,做键盘侠。
既然我说OpenClaw还是开源顶流,拿了github的排名说事,很多人可能还会质疑,那我就说一下,我在OpenClaw上搭建的工作流,当然,只是一部分。
第一个工作流是从文字材料到视频生成技能。
现代人们阅读文字的意愿(如果不是能力)越来越低,想要更好的讲一件事情,需要把文字内容制作为简单明白的视频内容。如果按照以前的做法,从文案、脚本、分镜、拍摄、后期、剪辑到最后视频制作,周期漫长、成本极高。有了AI以后,大可以这样做,先把需要制作的文字材料,改写为适合视频的文案,比如内容取舍、内容概括、包括转为更口语化的内容等等。这一步AI可以做得非常好了,我一般会让AI生成几个版本,然后按照我设定的评价体系,让AI从中选择一个最好的。
做工作流,有一个很重要的经验,就是每个步骤的中间结果都要有检查,有返工,不让问题留到下一个步骤,越早发现的问题,解决的成本越低,影响越小。所以,每个步骤的评价体系和返工的要求,是一个工作流能否稳定、高质量工作的关键。
有了文案以后,就要开始做分镜。一般按照文字内容中的场景切换、步骤等,让AI进行切分,而且每个分镜的时长,控制在5秒以内。因为太长了,后面的视频生成步骤时,会很容易出错,而且可选的模型也会更少。在分镜后,我会要求把各个分镜中出现的同一个人物角色、物品的信息提取出来,然后单独生成图片,给后续视频生成时参考。(这里也可以用同样的提示语,而不是图片作为参考,这样虽然在一致性上会差一点,但是成本会更低)同样,分镜完成以后,会检查分镜之间是否一致,是否衔接等等。
下一步是每个分镜的提示语了。在开始前,要确定好整体风格、画面比例这些信息,让每个提示语都带上。同样,提示语完成以后,要让AI自己通过设定好的checklist,进行仔细核查。提示语有了以后,就可以调用text2image或者image2image,有非常多的CLI或者API可选。生成图片以后,我还好找一个多模态的AI模型,来判断图片和提示语是否一致,图片中是否有不合理的地方等等,如果发现了,就让AI修改提示语,增加限制,然后重新生成
后面步骤也类似,用图片生成视频(image2video),增加旁白(text2speach),最后用ffmpeg把多段内容压到一起,增加背景音乐等等。不过目前,最后的剪辑,我还是手工完成,虽然AI可以实现,但是做得还不够好,而且最终还需要人的审美来判断某些内容要不要用,放在哪里用等等。
第二个工作流是文章写作技能。
这个非常有意思,并不是常用的AI批量生成文章的能力,让我慢慢说来。首先,现在读微信公众号文章,或者头条这样的,有UGC的内容的平台,非常多的文章,都会有一股浓浓的AI味,我总结了一下,比如事实性的错误,夸张的语气,自以为是的提法。我并不排斥AI生成的内容,但是这些让人读起来很不舒服的内容,我会坚决抵制。于是我先训练了一个AI文字检测的程序。
简单说一下原理,目前,任何一个主流的大模型,它的输出都是一个概率模型,比如上一个字是”你‘,下一个就会按照一定概率输出“好”,“是”等等,这个概率和候选字(词)的范围,每个模型是固定的。要检测一段文字,是不是ai生成的,只要看它是不是符合这个概率。网上还有一些通过特定句式、结构来判断是否是ai生成的内容,比如wiki百科里面有:Signs_of_AI_writing这部分内容,也有人基于这个专门做了去AI味的技能,比如humanizer。仅仅是基于ai生成常见句式来修改的方法,做起来很容易,让人读起来不那么难受,但是在检测模型前,无所遁形,因为修改以后输出的内容,还是会符合ai生成的概率模型。
知道这个原理以后,自己做一个ai检测的模型,就不难。首先要找一批人类写作的内容,比如2020年前的各种博客文章、知乎论坛、甚至电子书籍。内容形式尽量广泛(除非你想训练的是针对某个特定领域的内容),再找一批AI写作的内容,我是用各种模型(GLM、Qwen、deepseek、minimax、kimi、豆包等等)用同样的提示词和要求,生成了一批。这里有个小技巧,为了提升检测模型的准确度,可以增加同一篇文章用不同模型生成的混合内容。下一步,就是让ai基于这些内容,来训练模型,这里详细方法就太偏技术性了,就不冗述了。
目前,在特定方向内容上,我自己训练的模型,基本可以替代腾讯的朱雀大模型使用。有了这个ai判断模型以后,就可以做更多非常有意思的事情,比如如果要改变大模型输出的固定概率,就要把这个模型反过来用。
关于openclaw的升级,确实是它最大的问题之一,非常慢,而且我都遇到好几次升级失败的情况,只能一次一次自己手动来做,直接通过npm来重新安装,甚至是编译代码,更新以后通过openclaw doctor来修复配置文件里面的问题。不过最近几个版本,已经有了明显改善,比如9月的最后几个版本,及10月的第2个版本(10.1这个版本确实有问题)。我的建议是不急着升级,毕竟这原先是一个以个人开发者为基础的小项目,前期对不同系统考虑会少一点,有很多坑要填。现在openclaw仍然保持着非常高的发布频率,版本号规则是年+月,加上这个月的第几个版本。比如2026.9.9,就是2026年9月份的第9个版本,网上很多说什么openclaw 2.0的,看到这样的标题,可以直接拉黑作者,连openclaw的版本号命名规则都不懂,文章质量可想而知。
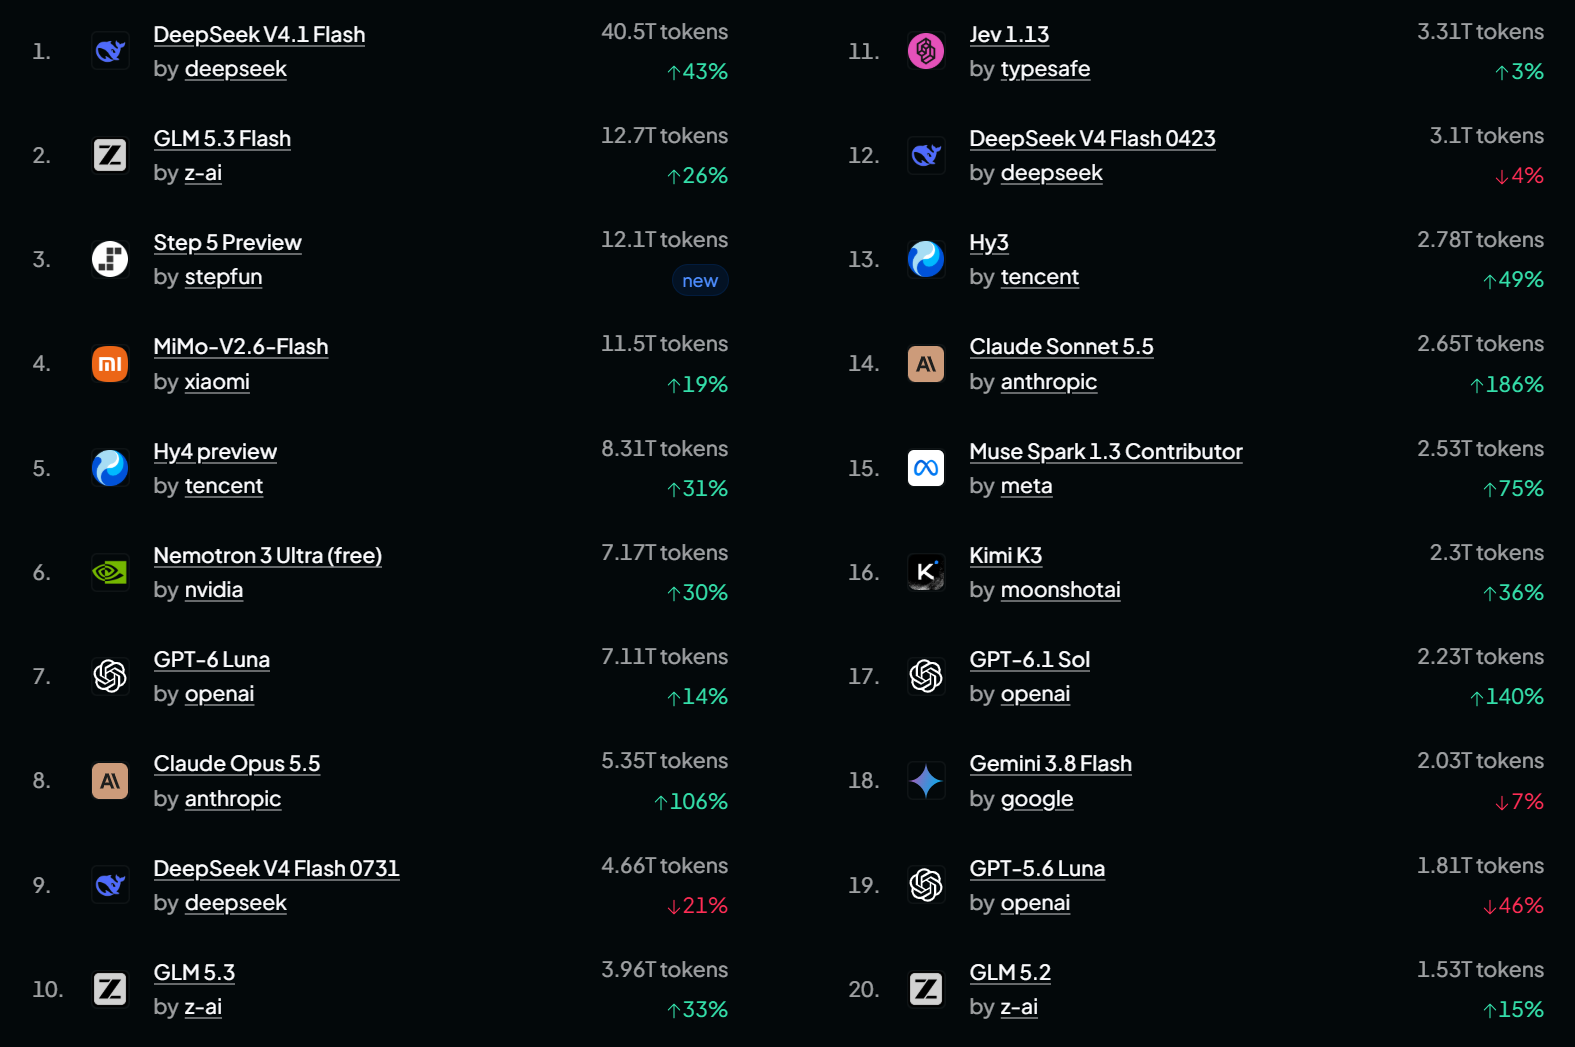
关于大模型的评分,大家可以参考,但是还是要以自己实际使用结果为准(所以,为每个结果设定一个可量化、可评价的结果,非常重要)。我感觉有些大厂的模型,有刷榜的嫌疑,而且每个人用AI完成的任务、要求都不相同,每个模型都有自己适合的场景。同样,建议不同的任务,使用不同的模型,比如coding,写作,agent,这三个常用任务,我就使用了三套不同模型,在价格和结果之间,获得比较好的平衡。总的来说,一个模型好不好用,不要看评分,要看实际付费情况下的使用量。截一个openrouter上各个模式的使用量信息:
有了openclaw或者其他harness这么好的工具,确实能大幅提升工作产出,空余时间可以用来做自己喜欢的事情,去户外徒步、去摄影、去读书,真正享受生活,我想这是AI给人类带来的真正的价值。还在继续使用openclaw,或者想使用,但是遇到困难的小伙伴们,可以在评论区留下你们的想法,也可以私信给我交流。